Map Reduce Challenge
- 很多的计算需要串起多个mapreduce job(如找出访问最多的网站,需要先排序再筛选)
- 两阶段的计算模型(map-reduce)太死板(很可能两轮工作都很简单,但是按照划分必须分成两轮进行)
- mapreduce只提供给你
map()和reduce(), 具体的算子需要你自己写
HIVE
- 即High Level Language, 使用高层语言/系统(如SQL)将其编译并跑在HDFS上的MapReduce
Data Model for HIVE
- HIVE的三层模型: Table(目录) -> Paritions(子目录) -> Buckets(文件)
- Table: 类似RDBMS中的Tables, 包含数据类型的columns,每张Table在HDFS上对应一个目录
- Partitions: 按照建表时的分区声明对应的分区列进行分区
- Bucket: 对key进行hash再取模,余数相同的归到同一个bucket中
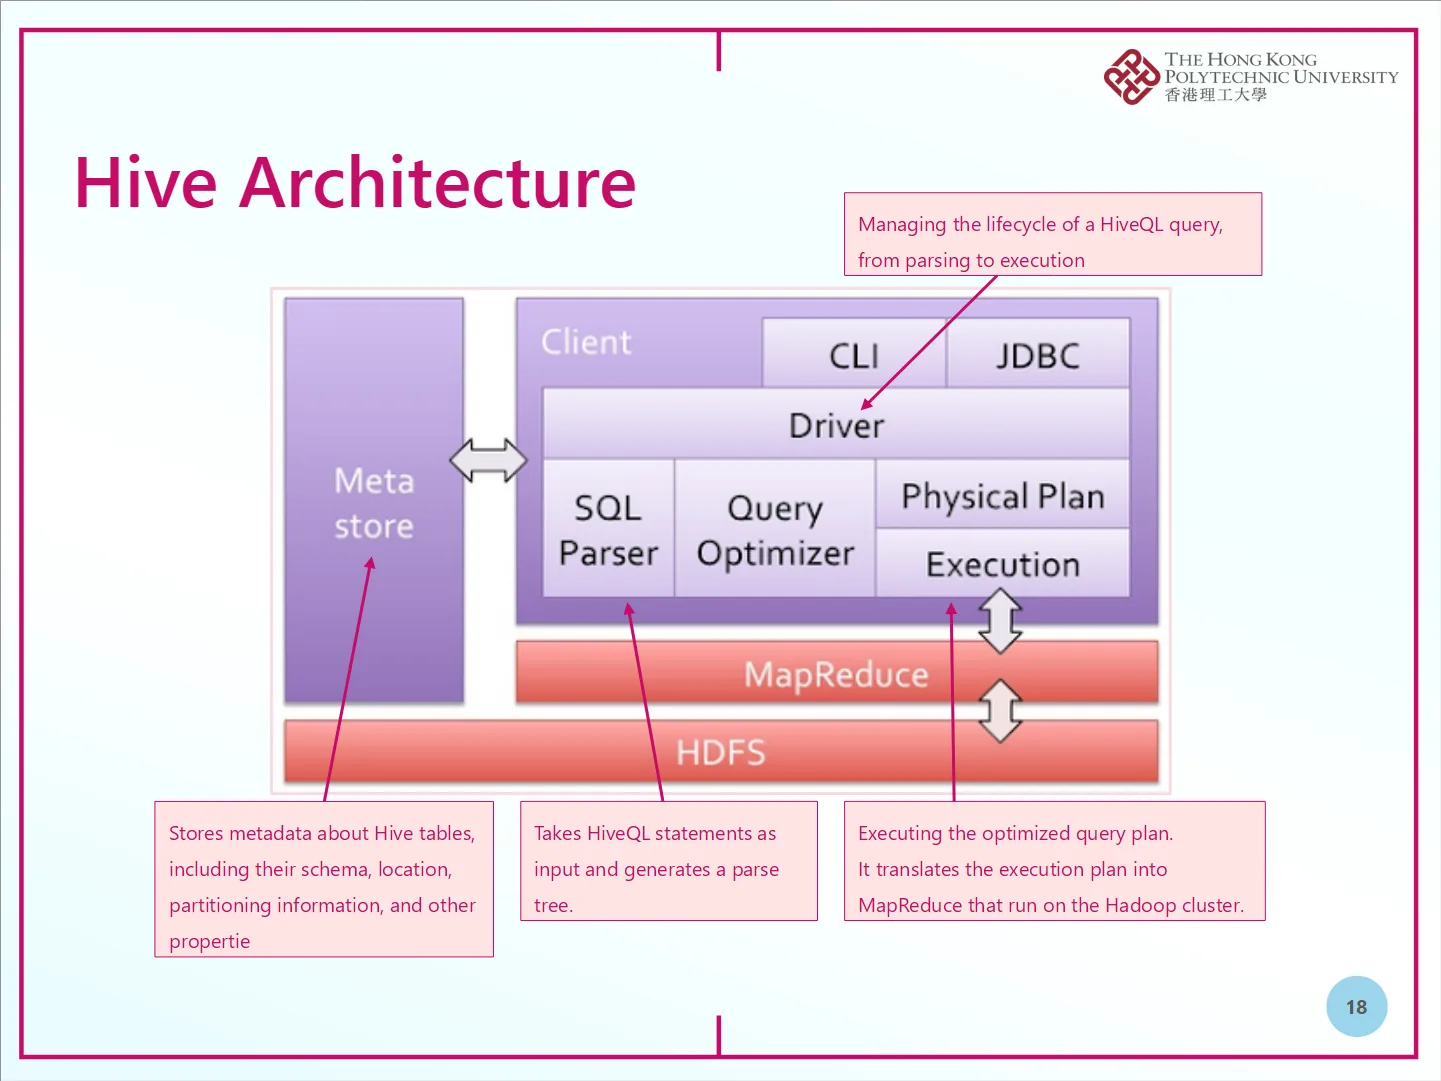
HIVE Architecture
- Meta Store: 独立于HDFS,存储Table的元数据(schema等)
- Client: 有CLI和JDBC两个入口,每次编译都要与Meta store交流
- Driver: 掌握每一条query的生命周期,内部包含四个组件
- SQL parser: 将语法变为语法树
- Query Optimizer: 将语法树整合成更省资源的逻辑计划
- Pyhsical Plan: 决定使用多少Map Reduce实现
- Execution: 将作业提交给Hadoop
Compilation step
- 解析HiveQL语句,主要是检查语法错误并生成表示查询结构的语法树
- 包含六个步骤,构成单向管线:
- parser: 检查是否符合语法并输出parse tree
- semantic analysis: 对语法树进行语义分析,提取schema并校验逻辑
- logical plan generator: 通过校验过的HiveQL语句生成逻辑计划
- optimizer: 对逻辑计划做优化以提升性能
- physical plan generator: 将逻辑计划转为物理计划(Map Reduce Jobs构成的DAG)
- execution: 执行
Key Principles of HIVE
- HIVE是一个开源的PB级别规模的数据仓库框架,建立在MapReduce和HDFS之上
- 面向 data warehosues/online analytical processing(OLAP)设计,注重可扩展性和可扩充性, 而不是为了online transaction processing设计的
- OLTP: 要求毫秒级响应,强一致,可回滚,例如银行转账
- OLAP: 扫描量大,高吞吐,不考虑延迟,最终一致,例如报表
- 定义了类SQL的查询语言: HiveQL
- 允许程序员插入自定义的mapper和reducer
- 提供数据仓库基础设施
- 提供让Data ETL(extract, transform, load)更容易的工具
Limitations of Hive
- High Latency: 使用MapReduce, 查询延迟很高,小查询往往也需要几分钟
- Limitted Support for Interactive Analytics: Hive是为批处理而生的,不适合交互式查询
- Complex Query Performance: 包含多个join或子查询的查询很慢,这是因为MapReduce基于磁盘的处理方式
- No Native Support for Adcanced Analytics: 缺少对机器学习/迭代算法的内部支持
Shark
- 仓库是PB级别的数据量,但是单次任务的输入数据中位数只有约15GB
- 因此可以通过将warehouse和working set分开,通过内存进行效率优化
- 同时数据仓库的查询也表现出极强的时间局部性
- 因此将负责physical generation和execution的引擎换成Spark基于RDD的执行引擎,加入cache manager并进行调整
- Shark兼容HiveQL,但是不再支持Bucketing, Heterogeneous Partition Formats, Result File merging, Automatic Join Optimization(以上特性依靠MapReduce物理特性)
Engine Extensions and Features
- In-Memory Table Caching: Shark允许将数据缓存在集群的内存中(使用
RDD.cache())
- Data Co-partitioning: 确保join key相同的记录在同一个分区中
- Cost Based Query Optimizer: 使用一个cost-based optimizer考虑多种执行策略并估算cost,选出更好的连接顺序或执行策略
- Partitial DAG Execution: 动态查询优化,允许通过运行时收集的数据统计来动态改动查询计划
- Columnar Memory Store: 在内存中不存在I/O瓶颈,选用列存可以更好的执行分析型任务,同时可以压缩空间(对重复值)
Shark was short live
- 然而Shark非常短命
- 因为他只能查询存放在Hive MetaStore中的外部数据,无法在Spark应用内部对原生处理数据进行SQL查询
- 同时必须在Spark程序中以SQL字符串的形式调用
- 由于优化器从mapreduce上迭代而来,因此仍然不够灵活
链接