Purpose of normalization
Normalization与ER Modeling类似,是另一种Database design technique.通过考察attribute之间的关系(又称为functional dependencies),并使用一系列测试(称为normal forms)以此确定属性之间的最佳分组.
一组合适的关系应该具备以下特点:
- 具有紧密逻辑关系的attribute位于同一关系中
- minimal redundacy:每个属性只表述一次(除了foreign key)
Data Redundancy and Update Anomalies
Data Redundancy
数据库设计的主要目标是将属性分组到关系中,以最大限度地减少数据冗余
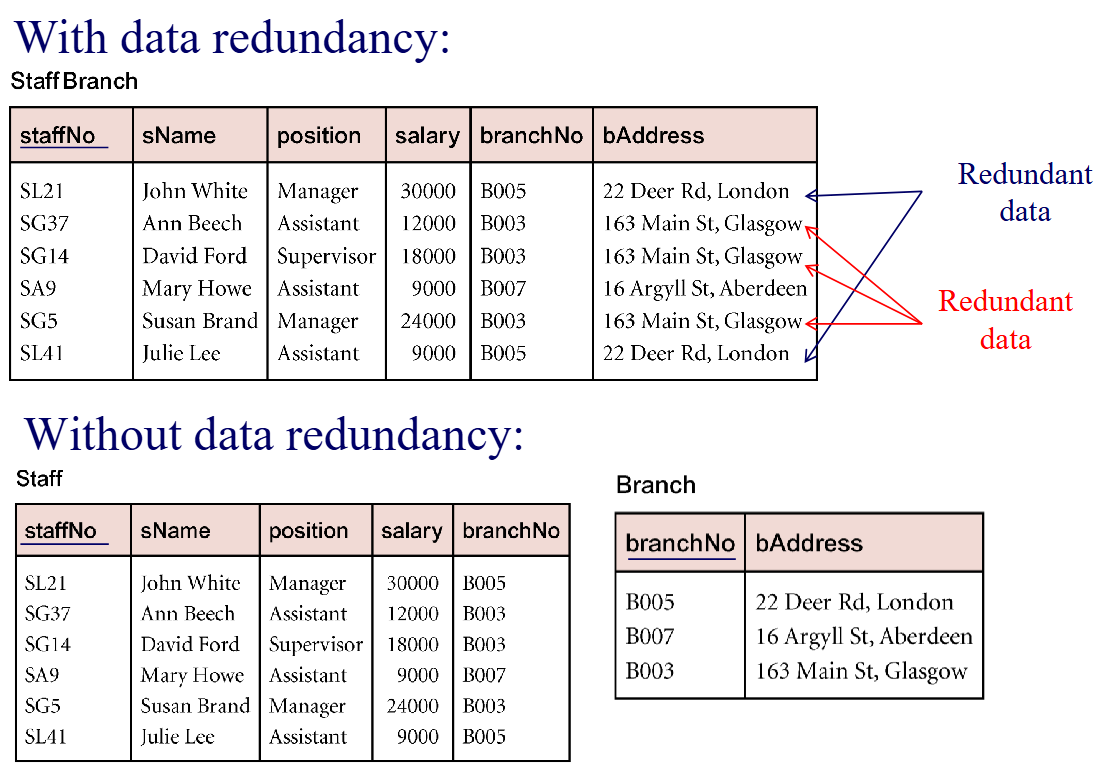 (bAddress和branchNo重复出现)
Update Anomalies
包含冗余信息的关系可能出现更新异常,更新异常包括以下几种
- Insertion: 想存新branch信息却因为暂时没有staff而存不进去(因为primary key不能为空)。
- Deletion: 删掉某个staff时把关联的branch也删除了
- Modification: 想改一个branch需要改多个重复的branch
Functional Dependency
Functional dependency (FD) 是与归一化相关的重要概念,其被用于描述attribute之间的关系.FD的定义如下:
- 若A和B都是ralation中的attributes
- 根据唯一的 A 的值,就一定能确定 B 的值
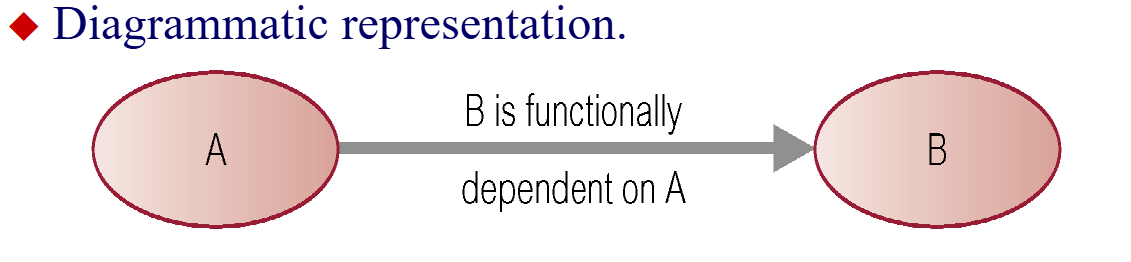 (左侧的A被称为determinant,右侧的B被称为dependent)
特殊情况:Partial dependency:发生在使用复合主键(由多个属性共同组成)时,如果某个非键属性(如 branchNo)不需要依赖完整的主键(如 staffNo, sName),而只需要依赖主键中的某一个子集(如仅靠 staffNo)就能被唯一确定,这种情况就称为部分依赖。
一个真实高效的函数依赖必须具备:
- 唯一性:给定左边,右边一定唯一
- 永久性:由数据的性质得知,永久成立(如编号肯定对应单独的员工,而姓名可能重名)
- 最小化:不存在partial dependency,要最小化attribute数量 Transitive Dependency:若 A→B and B→C,则有A→C
The process of normalization
UNF → 1NF
UNF(Unnormalized Form):一个包含多个重复组的table 1NF(First Normal Form):行与列的交集只包含一个值的table 过程:将重复组拆开,确保每一个单元格都是原子值
1NF → 2NF
2NF(Second Normal Form):消除了部分函数依赖的关系表 过程:将部分依赖的属性分离出去,创建新表
2NF → 3NF
3NF(Third Normal Form):消除了传递函数依赖的关系表
过程:将传递依赖的属性分离出去,创建新表
ppt中的tut8需要牢记